Node 文件遍历工具的迭代:从 walk 到 readdir,再到 tinyglobby
文件遍历常被当成小事,直到它进了发布脚本。
写进工具后,它往往会变成一串细节:要不要递归、要不要只要文件、要不要包含 dotfile、符号链接怎么办、输出路径是系统路径还是 URL 路径、Windows 反斜杠要不要处理、远端对象存储需要什么 key。
这次问题来自一个发布脚本:Hexo 生成 public 目录后,需要把里面所有文件上传到 OSS。ali-oss 提供的是上传单个对象的 API,不能把「上传一个文件夹」这件事完整托管给 SDK,所以脚本必须自己把文件枚举出来,再逐个上传。
OSS PutObject 文档 描述的是上传一个 object。OSS 的核心模型是 bucket 里的 object key,不是本地文件系统里的目录树。所谓目录通常是通过 key 里的
/前缀模拟出来的。
所以脚本需要完成两步:枚举 public 下的文件,为每个文件生成 OSS object key。下面记录这段遍历代码的几次替换,以及最后保留的路径约束。
第一版:walk 把细节藏在事件里
旧写法使用的是 walk。
const OSS = require('ali-oss');
const walk = require('walk');
const slash = require('slash');

const walker = walk.walk('./public');

walker.on('file', async (root, fileStats, next) => {
  root = slash(root);

  const { name } = fileStats;
  const objectKey = root.replace('./public', '') + '/' + name;
  const filePath = `${root}/${name}`;

  const result = await client.put(objectKey, filePath, {
    headers: {
      'Cache-Control': 'max-age=31536000, must-revalidate',
    },
  });

  console.log(`${result.name} -> ${result.url}`);
  next();
});
这段代码有一个好处:主流程里不需要判断 isFile()。因为 walk 已经把遍历结果按事件分好了,只有文件才会进入 file 事件。
上传逻辑却分散在事件回调里,还要协调 async 回调和 next():哪一步结束才能继续遍历,异常怎样传出去,主进程何时退出,都不如普通的循环直接。再加上 root.replace('./public', ''),阅读时还得追一遍路径怎样被裁掉。
这次替换的目标,是让上传顺序、错误传播和路径生成都能在主流程里读出来。
第二版:readdir 更标准,但暴露了底层细节
Node 标准库里有 fs.promises.readdir。
配合 recursive: true 和 withFileTypes: true,可以一次拿到递归目录下的 Dirent 列表。
import { readdir } from 'node:fs/promises';
import { join, relative } from 'node:path';
import slash from 'slash';

const entries = await readdir(publicDir, {
  recursive: true,
  withFileTypes: true,
});

for (const entry of entries) {
  if (!entry.isFile()) {
    continue;
  }

  const filePath = join(entry.parentPath, entry.name);
  const objectKey = `/${slash(relative(publicDir, filePath))}`;

  await client.put(objectKey, slash(filePath), uploadOptions);
}
这版不再依赖 walk,上传按 for...of + await 的顺序执行,错误也能沿 Promise 传给调用方。
但它也把两个底层问题暴露到主流程里。
第一个问题是文件过滤。
readdir 返回的是目录项,不是「文件列表」。它可以告诉你每一项是不是文件、是不是目录、是不是符号链接,但没有 onlyFiles: true 这种选项。所以主流程必须写:
if (!entry.isFile()) {
  continue;
}
第二个问题是路径语义。
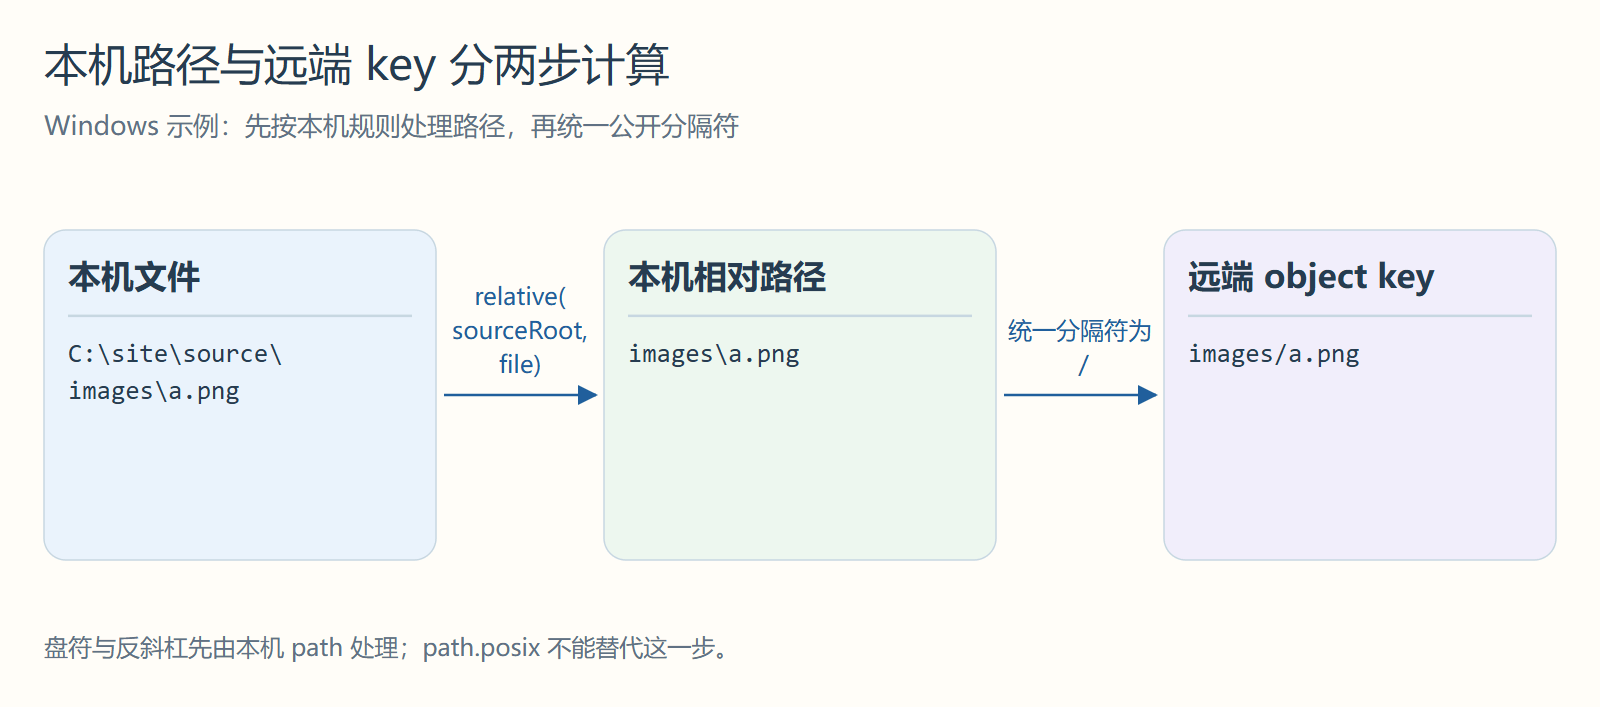
join()、relative() 处理的是本机文件系统路径。macOS / Linux 下是 /,Windows 下是 \。但 OSS object key 和 URL 更接近 POSIX 路径,应该稳定使用 /。
因此脚本又需要 slash(relative(...)) 这样的转换。
发布流程因此需要同时处理 Dirent、isFile()、parentPath、relative() 和 slash()。读者要先理解目录项和路径转换,才能看出脚本要上传哪些文件。
Node.js
fsPromises.glob已经进入标准库,Node 24 / 22.17 起标记为 stable。它返回匹配 pattern 的文件路径,也支持cwd、exclude、withFileTypes等选项。这说明 Node 标准库也在往 glob 语义补能力,但生态里的成熟 glob 库仍然有更丰富的工程经验。
那为什么没有直接用 fs.glob?
当前脚本想要的是「拿到 public 下面所有可上传文件的相对路径数组」。fs.glob 在这个场景里还要多处理几件事。
第一,它返回的是 AsyncIterator,如果后面要排序、统计、dry-run 或复用文件列表,通常还要先把它转成数组。
import { glob } from 'node:fs/promises';

const files = [];

for await (const objectPath of glob('**/*', { cwd: publicDir })) {
  files.push(objectPath);
}第二,glob('**/*') 会同时匹配文件和目录,而 OSS 上传需要的是文件列表,因此还得过滤目录项。
import { glob } from 'node:fs/promises';
import { join, relative } from 'node:path';
import slash from 'slash';

const files = [];

for await (const entry of glob('**/*', {
  cwd: publicDir,
  withFileTypes: true,
})) {
  if (!entry.isFile()) {
    continue;
  }

  files.push(slash(relative(publicDir, join(entry.parentPath, entry.name))));
}
这段代码已经比 readdir 接近问题本身,但主流程又重新出现了 withFileTypes、isFile()、parentPath 和 relative()。它解决了「pattern 匹配」,但还没有直接表达「只要文件列表」。
这里的 parentPath 是本机文件系统路径,不能直接交给 path.posix 处理。Windows 的反斜杠在 POSIX 路径规则里不是分隔符;先用本机的 join() 和 relative() 算出相对路径,再转换为 /,才不会把盘符和整段目录名混进远端 key。
第三,要核对宿主项目的 Node 版本。fs.glob 在 Node 22.0.0 才加入,Node 24.0.0 / 22.17.0 才标记 stable;运行环境已经锁定在这些版本的项目可以直接评估它。这次脚本还希望少处理文件过滤、数组收集和路径输出,我更愿意用一个小型 glob 库承接这些细节。
第三版:tinyglobby 把「要哪些文件」说出来
如果脚本要做的是「匹配 public 下所有文件」,glob 工具会更贴近问题本身。
Vite 的 import.meta.glob 就是这个方向。
Vite 文档 明确写到,
import.meta.glob的匹配由tinyglobby完成。Vite 还在插件 API 文档里强调 path normalization:Vite 会把路径规范化为 POSIX/分隔符,并导出normalizePath()帮插件处理跨平台路径比较。
用 tinyglobby 改写发布脚本后,主流程会更像业务描述。
import { glob } from 'tinyglobby';
import { posix } from 'node:path';

const files = await glob('**/*', {
  cwd: publicDir,
  dot: true,
  onlyFiles: true,
  expandDirectories: false,
});

for (const objectPath of files) {
  const filePath = posix.join(publicDir, objectPath);
  const objectKey = posix.join('/', objectPath);

  const result = await client.put(objectKey, filePath, {
    headers: {
      'Cache-Control': 'max-age=31536000, must-revalidate',
    },
  });

  console.log(`${result.name} -> ${result.url}`);
}
这版代码里,「只要文件」变成了 onlyFiles: true。
「从 public 目录算相对路径」变成了 cwd: publicDir。
「延续旧脚本的 slash 风格本地上传路径」变成了 posix.join(publicDir, objectPath)。
「远端 key 使用 POSIX 路径」变成了 posix.join('/', objectPath)。
主流程不再需要知道 Dirent 是什么,也不需要手写 isFile()。
这次新增依赖换来的,是把递归和文件过滤交给库。脚本仍然负责上传,以及本地路径和远端 key 的转换,责任没有全部转移给 tinyglobby。
替换前还要比较实际文件集合:隐藏文件是否包含、符号链接是否跟随、结果是否需要排序、读取失败怎样传播,都可能改变发布结果。这里显式设置了 dot: true,不能把前面的 fs.glob('**/*') 示例当成行为完全相同的替代。
tinyglobby 文档 把自己定位成 globby / fast-glob 的轻量快速替代。它默认
onlyFiles: true,内部使用fdir和picomatch,并被 Vite、pnpm、Vitest、Astro、UnoCSS、VitePress 等工具使用。
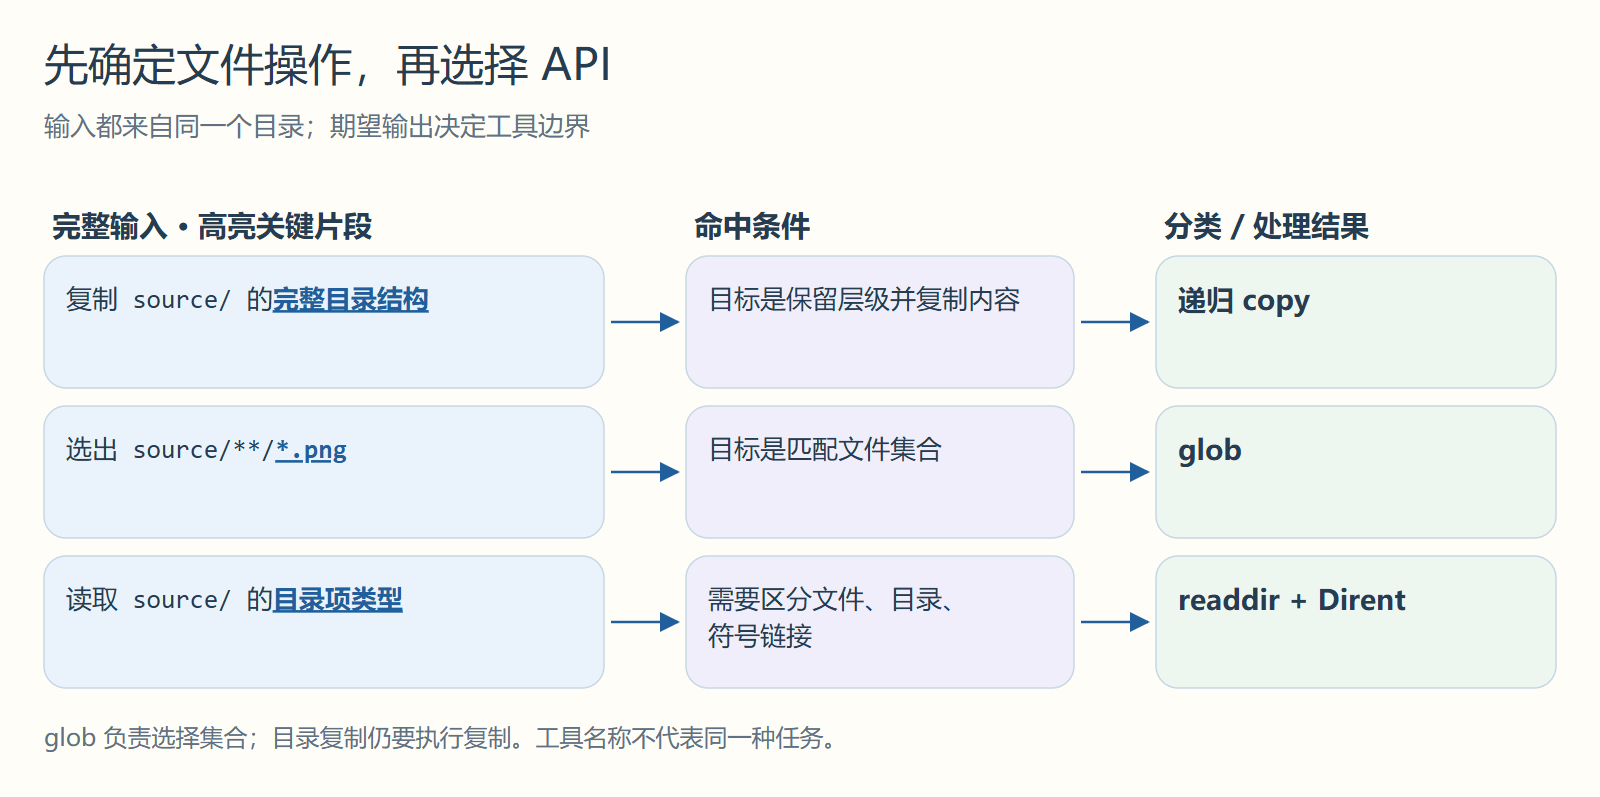
Vite 不是所有地方都用 glob
Vite 在文件匹配和目录复制中选了不同工具。import.meta.glob 用 tinyglobby 选择文件,publicDir 构建复制则用类似 copyDir(srcDir, destDir) 的递归实现:读目录、判断类型、递归、复制文件。
Vite
utils.ts里能找到copyDir这类目录复制工具;ViteimportMetaGlob.ts里能找到tinyglobby用于import.meta.glob的匹配。两个场景的工具选择不同。
复制目录需要保留目录结构,glob 则选择要处理的文件集合。发布脚本也按这个区别选工具:先确定操作,再看哪种 API 能直接表达它。
Node 标准库、tinyglobby 和 walk 的取舍
几个选择的取舍如下表所示。
| 工具 / API | 适合场景 | 主要问题 |
|---|---|---|
walk |
老项目里已经存在、事件式遍历已经稳定运行 | 需要协调事件回调、异步上传和 next(),错误传播也要核对 |
fs.readdir |
想少依赖,愿意自己处理文件过滤、递归和路径转换 | 不直接表达 onlyFiles,主流程容易被 Dirent 细节占据 |
fs.glob |
新 Node 环境,想用官方 glob,需求比较简单 | API 比较新,生态经验和复杂 glob 能力还不如成熟库充分 |
tinyglobby |
枚举文件、匹配模式、生成相对路径、直接过滤目录项 | 新增依赖及其升级责任;上传 SDK 的路径要求仍需自己处理 |
fast-glob / globby |
已有项目已经使用,或需要它们已有生态能力 | 依赖更重,新项目不一定需要从它们开始 |
如果只是复制目录,标准库或手写递归可以接受。
如果是「找出所有要处理的文件」,tinyglobby 会更适合。
如果团队运行环境已经固定在新 Node,也可以评估 fs.glob,但要确认它的 pattern、exclude、路径输出和平台行为是否满足需求。
路径要先分清语义,再决定是否保持旧行为
文件遍历脚本里最容易混在一起的是两类路径。
第一类是本地路径,用于读文件、上传文件、判断文件是否存在。新写脚本时,通常可以交给 node:path 的普通 API,例如 join(publicDir, objectPath),让 Node 按当前系统生成路径。
第二类是远端 key,用于 OSS、URL、manifest、缓存 key。它不应该随系统变化,而应该稳定使用 /。
const filePath = join(publicDir, objectPath);
const objectKey = posix.join('/', objectPath);
这两行代码比 split(sep).join('/') 更容易读,因为它把意图说出来了:
filePath是本地文件系统路径。objectKey是远端 POSIX 风格路径。
不过这次发布脚本还有一个额外约束:旧版 walk 脚本会先执行 root = slash(root),再把本地文件路径写成 ${root}/${name}。旧版传给 ali-oss 的 filePath 本来就是 slash 风格。
当时的工作环境是 macOS,没有验证 Windows 下 ali-oss 对原生反斜杠路径的处理。我没有在替换遍历工具的同时改变上传 SDK 收到的路径形态,最终代码选择:
const filePath = posix.join(publicDir, objectPath);
const objectKey = posix.join('/', objectPath);
这时两者都是 slash 风格,但语义不同:
filePath是延续旧行为、传给ali-oss读取本地文件的路径。objectKey是 OSS 上的远端 object key。
如果脚本里大量出现 replace('\\', '/')、split(sep).join('/')、root.replace('./public', ''),通常说明路径语义还没有拆干净。
回到发布脚本,推荐的写法是什么
对这次 Hexo public 上传 OSS 的脚本,我保留了 tinyglobby + posix.join:先拿到文件的相对路径数组,再逐个上传,远端 key 始终使用 /。主流程只留下匹配、路径映射和上传:
import { glob } from 'tinyglobby';
import { posix } from 'node:path';

const publicDir = './public';

const files = await glob('**/*', {
  cwd: publicDir,
  dot: true,
  onlyFiles: true,
  expandDirectories: false,
});

for (const objectPath of files) {
  const filePath = posix.join(publicDir, objectPath);
  const objectKey = posix.join('/', objectPath);

  const { name, url } = await client.put(objectKey, filePath, uploadOptions);

  console.log(`${name} -> ${url}`);
}
dry-run、并发、重试和上传统计可以围绕这份文件列表继续扩展。换用 tinyglobby 减少了事件协调、目录项过滤和部分路径裁剪代码,代价是多维护一个依赖。
本地上传路径仍保持旧脚本的 slash 形式,改成 Windows 原生反斜杠路径的效果尚未验证。这次也没有做速度基准;按性能选型时,需要固定文件集合、过滤规则和运行环境再测量。